


Разработан новый алгоритм для улучшения работы диффузионных моделей
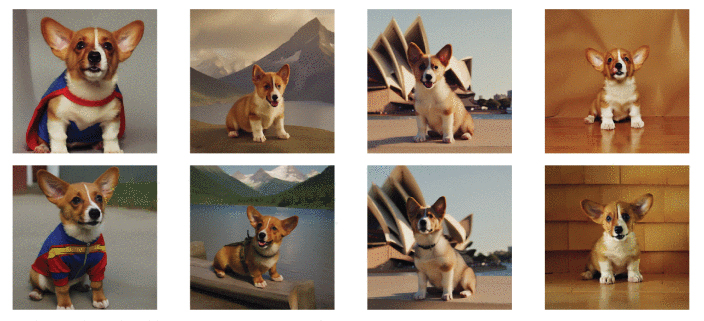
Исследователи Московского физико-технического института (МФТИ), Высшей школы экономики и Института системного программирования им. В.П. Иванникова РАН создали нейросетевой алгоритм, который помогает сервисам-генераторам изображений точнее выбирать на фото нужные объекты.
Диффузионные модели — это класс генеративных нейронных сетей, которые способны отделять объект на изображении от фона. Они буквально превращают фото в набор точек, а затем программа в обратном направлении, превращает случайный шум в картинку по текстовому описанию. Технология DreamBooth позволяет «дообучить» такую модель под конкретный объект — человека, питомца, товар, используя несколько целевых фотографий. Проблема заключается в том, что при малом количестве обучающих примеров модель запоминает не суть объекта, а случайные детали конкретных фотографий. Это называется меморизацией контекста, и бороться с ней при минимуме данных крайне сложно.
Процесс диффузии состоит из нескольких шагов: на каждом шаге к изображению добавляется немного шума, пока оно не превратится в случайный «белый шум». При обучении нейросеть учится предсказывать, какой шум был добавлен на каждом шаге. Ключевое наблюдение авторов: шаги с малым шумом (в начале процесса, близко к чистому изображению) несут в себе тонкие детали внешности — текстуры шерсти, форму носа, характерный цвет глаз. Шаги с большим шумом (в конце) кодируют только грубую глобальную структуру — общую форму, схему расположения элементов. Стандартное обучение выбирает шаги случайно, равномерно, то есть одинаково много внимания уделяет как «детальным» малошумовым шагам, так и «структурным» сильношумовым. Исследователи предложили это изменить.
Разработанный метод P-LoRA (Probability LoRA) изменяет распределение вероятностей, с которым выбираются шаги диффузии при обучении. При этом фокус модели математическими средствами сместили в пользу малых шумов. Они несут информацию о тонких деталях образа. Инновация позволяет программе «запоминать» больше значимых характеристик объекта, практически не требуя для этого дополнительных вычислительных ресурсов.
Авторы протестировали три конфигурации: обычный DreamBooth с равномерным выбором шагов, P-LoRA с уклоном в сторону малошумовых шагов и P-LoRA с уклоном в сторону сильношумовых (как контрольный эксперимент). Оказалось, что умеренный уклон к малошумовым шагам улучшает редактируемость, то есть способность нейросети откликаться на новые текстовые запросы, помещая объект в неожиданные контексты, при этом не теряя качества воспроизведения объекта. Уклон к сильношумовым шагам снижает «запоминание» фона, но за счет худшего воспроизведения самого объекта. Для оценки результата авторы также ввели новую метрику — чистый показатель реконструкции, который перед измерением схожести с эталонной фотографией предварительно вырезает фон с помощью модели сегментации. Это позволяет измерять именно то, насколько хорошо модель «выучила» объект, а не случайные детали окружения.
«Главная идея — очень простая: не все шаги диффузии одинаково полезны для обучения персонализированной модели. Малошумовые шаги несут в себе ту тонкую информацию об идентичности, которую мы хотим, чтобы модель выучила. Перераспределив туда больше обучающих примеров и исправив математическое смещение контрвесами, мы смещаем внимание модели именно туда, где оно нужно», — рассказал один из разработчиков, магистрант кафедры алгоритмов и технологий программирования МФТИ Максим Фофанов.
Авторы отмечают, что новый алгоритм можно встроить в любой существующий диффузионный пайплайн буквально за несколько строк кода. Такая «легкость» особенно ценна для практиков, которые работают с ограниченными вычислительными ресурсами и не могут себе позволить полное переобучение больших моделей.